AI
OpenClaw 作者 Peter 在社媒发帖,声称开发者不应该继续直接写 Prompt,而应该设计 Loop(循环) 来 Prompt Agent。
这个帖子引发开发者热议,诞生了新的词汇 “Loop 工程” 与 “Loop 工程师” 等等。
作者:划水的青蛙
链接:https://www.zhihu.com/question/2048003050531558553/answer/2048042592902943048
来源:知乎
著作权归作者所有。商业转载请联系作者获得授权,非商业转载请注明出处。
过去一年,Agent开发领域连续造了三个词。
2025 年中,Context Engineering。
2026 年初,Harness Engineering。
2026 年中,Loop Engineering。
每个词出来后,大家其实都有点云里雾里,为什么?因为随着深入了解,感觉每个词中涉及的概念,和其他词都互有重叠。比如Harness中的很多落地手段,其实也是在合理管理上下文。
所以,这三个词不是替代关系,是叠加与包含关系。新的概念并不是干掉老的概念,而是在老概念的基础上,随着业界出现新的问题,又进行的“填坑”。
在真正工程落地实践时,三个概念往往处于一种叠加态。任何一个部分没做好,可能都会影响整个Agent的效果。
三个词,三次更细化的总结
Context Engineering,2025 年中。 Context Engineering,讨论的核心很单纯。上下文窗口是稀缺资源,不管是从Token Cost管理的角度,还是模型效果的角度,在Agent工作的过程中,上下文窗口中塞什么、不塞什么、按什么顺序塞,都需要有合理的管理。
Harness Engineering,2026 年初。 上下文管好了,新的问题冒出来,Agent 一旦跑长任务,模型自己的能力短板就藏不住了。
比如,
- Agent循环时,陷入所谓的“复读机”情况,一直陷入了一个“舒适区”,不肯换一个方式解决问题,从而导致任务陷入死循环。
- Agent越权,进行了危险操作,在Prompt中的软约束失效,需要用硬约束来兜底
- Agent丢记忆,上下文尽管塞了所有信息,但是重要的信息被稀释了,模型可能抓不住重点。(这层和上下文工程相关)
所有给Agent加约束的工程手段都被装进 Harness这个筐。
不管是Claude Code源码逆向出来的各种机制,或者Hermes开源的自进化,以及Anthropic博客里讲的多sub-agent实现长程任务,本质上都在卷这一层。
Loop Engineering,2026 年中。 OpenClaw作者,Peter Steinberger和Anthropic Claude Code的负责人Boris Cherny几乎前后脚说了同一句话:
我不再 prompt Agent 了。我设计 loop,让 loop 去 prompt Agent。
这句话怎么理解?
简单理解就是,你不再亲自操作Agent,你应该设计一个让Agent自己运转的系统。
但是听起来有点抽象,什么叫“让Agent自己运转的系统”,那和现在OpenClaw、Hermes中支持的cron job又有什么区别?
在讨论这些问题时,我想再次梳理下这几个词的关系。
三个词之间的真实关系
Context和Harness之间,其实没有明显的边界。
今天业界总结出来的 Harness 手段,相当一部分本来就在管上下文,skill 渐进式披露是上下文,sub-agent 隔离是上下文,checkpoint恢复也涉及上下文重建。
Context Engineering可以算 Harness 的一个子集,至少高度重叠。
但 Loop 是真的另起了一层。
有的人觉得,Harness关心的是:一个Agent怎么跑不崩,能够正常完成任务。Loop关心的是:一堆Agent怎么被一个系统组织起来,自己跑、自己验证形成一个自循环。
这个并不是多Agent和单Agent之间的区别,Anthropic有篇比较经典的博客:
harness-design-long-running-appswww.anthropic.com/engineering/harness-design-long-running-apps
展示了怎么通过Harness,完成长程编程。里面用了三个Agent进行协作,一个负责计划,一个负责实现,一个负责评估。这不也是一堆Agent怎么被组织起来完成个任务么?
其实真正的区别是,任务的时间形态。
- Harness服务于一次有限任务,人给一个任务,agent协作做完,然后整个系统退场。
- Loop 服务于一项持续职能,没有终点,只有下一轮什么任务时候开始。
说白了,Harness有点像厨房里的工作,你要给厨师提供菜谱和合适的工具,然后厨房出一道菜,这个闭环就结束了。但Loop有点像开一个餐厅,你不亲自炒菜,你设计的是餐厅几点开门、厨房的工序怎么设计、菜单多久换一次、客人差评进哪个流程、库存少了谁补。
Loop更贴近所谓的自动化。
所以,你想直接上 Loop,需要先把Harness做扎实,这个又是另一个话题了。
这篇文章的范围
适合你:
- 你知道这三个词,但说不清区别,总怀疑是不是换个壳在讲同一件事,那这篇文章能够一定程度上让你对他们边界的理解上一个台阶。
- 你刚开始学习Agent,被这些短时间出现的名词反复轰炸,已经开始觉得只要不学,就不会落后。那么这篇文章至少能给你理顺这些概念。
- 你看了Addy Osmani那篇Loop Engineering博客(https://addyosmani.com/blog/loop-engineering/),被里面反复提及的automations / worktrees / skills / sub-agents绕晕,想找一个形象的例子能对上号。那这篇文章会用实例讲解一下。
帮不了你,如果:
- 你想要直接能运行的Loop Engineering代码示例,目前Github上有个小的实现,https://github.com/cobusgreyling/loop-engineering
- 你如果就是觉得Agent圈这些名词是硬造词,凹概念。但你已经对这些落地方法烂熟于心了已经进入不滞于物,无招胜有招的境界,那么希望你帮我指正下这篇文章可能出现的错误。求大神带带我。
阅读推进路径
接下来四步:
- 回到 Context Engineering,看清楚这层解决的问题。
- 看Harness有哪些部分和Context Engineering不同,又是为了解决哪些问题落地了哪些方法。
- 拆解Loop Engineering,真正理解前面所说的区别在于完成任务的时间形态。
- 最后总结下,Loop Engineering到底是在凹了个新词,还是确实有些新东西。
读的时候牢记这句话,你每落地一层,你的决策权就会往上提高一层。
这是这三个词背后唯一重要的事,别的都是细节。
Step 1:上下文工程,让 Agent 看见该看见的东西
先回到第一层。上下文工程的核心命题是:Agent 的上下文窗口是一个稀缺资源,你得决定往里塞什么、不塞什么、塞的顺序。
具体来说,上下文工程要解决这三个问题,
第一个是信息选择。
你的代码库有十万行代码,Agent在当前这一步只需要看哪几段?
之前Agent工作中已经产生了大量中间过程数据,哪些数据对当前任务是有用的,哪些可以抛弃?
这是第一层自主权的边界。你决定了信息范围,Agent 在这个范围内自行发挥。
第二个是信息组织。
同样一堆信息,怎么排、怎么分块、用什么格式包装,Agent 的判断路径会完全不一样。
就拿位置来说,模型都有一个Lost in Middle问题,尽管目前模型支持的上下文窗口能达到百万级,但是中间的信息,依然容易被忽略。
那么,最重要的信息应该怎么放?
同时,各种模型的API接口,都支持Prompt Cache功能,如果你发送给模型的前缀能够命中Cache,那么会大大降低这次请求的成本。怎么在不改变前缀信息的情况下,合理组织重要的信息?
第三个是Tool和Context的关系。
Agent能调什么工具,决定它能自己拿到什么上下文。工具列表的设计本质上是上下文工程的延伸。
你通过控制工具来控制 Agent 能触达的信息边界。比如,你给Agent提供了“grep”工具,那么Agent就能自己通过调用这个工具,来获得合适的上下文。
这层做对了的标准是,Agent不需要你反复补充上下文就能正确理解当前任务范围。做错的表现是,Agent 反复问你已经说过的事,或者猜错你的意图然后越跑越偏。
上下文工程这层,你交出的是信息选择权。Agent 在给定上下文窗口内自主决定看什么细节、调什么工具。但你仍然保留每轮结束你检查结果,决定是否继续的权力。
Step 2:Harness工程,让Agent稳定完成任务
Harness的核心在于,能否让Agent稳定地完成长程任务?
这里面有两个部分,
第一个是,通过一定的工程手段,让能力相对较弱的模型,完成复杂任务。
第二个是,通过一定的工程手段,优化模型的完成任务路径,提升Agent的效率,或者降低Agent的成本。
业界这一年卷出来的Harness手段不少,Claude Code 的源码泄露后,里面各种各样的方法,Anthropic 自己也发过 harness design的博客,也有Hermes这种自进化的玩法。总结一下,本质上都在兜四类底。
第一种,还是管理上下文,对上下文进行的压缩、隔离、持久化
Agent跑长任务,上下文窗口迟早会遇到上限。那么与之而来的两个问题,怎么让之前的上下文进行无损保留,和损失相对较小的压缩?
Claude Code的做法是,进行结构化摘要,并不是自然语言叙述形式的摘要。把历史对话总结成已经做了什么、决定了什么、还剩什么没做的形式,再用这个压缩版替换原始历史。
Sub-Agent隔离,主Agent不去读一些较大的文件,比如超长日志、外部文档等,而是启动一个Sub Agent,来做重要信息的摘要,接着把这个摘要返回给主Agent。本质上就是把上下文窗口隔离开,避免脏数据,污染了主要工作的Agent的历史窗口。
持久化,有两种情况,第一种是持久化你的工作历史记录,第二种是持久化知识。工作历史记录完整地存储成JSON文件或者Markdown文件,如果摘要时候丢失重要信息,还能从这些原文件中重新获得原始信息,进行二次总结。持久化知识其实就是我们常用的Skill或者Claude.md文件,把解决任务中需要的稳定、复用率高的知识,例如代码规范、领域术语、踩坑记录等放进文档中,让Agent工作时放System Prompt中,或者渐进式加载。
这些方法实际上和上下文工程重叠程度很高,因为这些手段,仍然是在解决给模型“看什么”的问题。区别仅仅是,这些方法更加细化。
第二种,Agent 跑偏 ,卡死怎么办,进行循环检测,或者结构化计划
正如前文所说,Agent在某些工作时,容易陷入“复读机”的状态。一直使用重复的方法,来解决任务。导致空烧Token。这时候需要做的是及时进行介入,让Agent换个思路。
方法也有很多,比较经典的是,在Agent外,设计一个旁路监控,对Agent每轮的Action,进行监控。一旦发现反复几轮,调用了同样的工具,给工具传入了同样的入参。那么就注入一条信息,提醒Agent,已经重复了多轮,需要它换个思路。
这种软干预的方式很有用,Langchain在刷榜Terminal Benchmark 2.0时,给他们的Agent加了这个组件,然后提升了任务的成功率。
另外一个方法,就是所谓的结构化的计划,强制Agent在工作前,给自己先弄一个TODO List,每步照着List,逐一核对结果。Anthropic那篇长程编程的blog,实际上算是这个方式的进阶版,把单Agent中作计划这个过程,抽离出来,让一个子Agent去专门做这个事情。评估也是如此。
第三种,Agent如果跑崩了怎么办?设计checkpoint机制进行恢复
如果一个Agent跑任务,在某一步崩溃了,提前退出。没有checkpoint的话就需要重跑。但是有checkpoint的话,就能重新加载之前的工作进度,不用从头开始。这样相对来说能够省下一大部分时间和写的token。
第四种,Agent的权限控制
很多人在设计Agent时,会把一些关键指令放System Prompt中。比如“不要执行Delete操作”“不要执行rm -rf等等。但在Prompt中设计这些指令,对于LLM来说,只能算是一个软约束。你不能指望Agent每次都严格遵循这些指令。只要100次操作里,有1次没有遵循,那结果就是灾难性的。
所以,不管是Claude Code还是别的Agent,在设计时,都会增加黑白名单机制,作为硬约束。一旦检测到模型输出的tool call或者result,可能包含危险指令,要么直接中断,要么交由用户自己确认。
除了这四种,还有一种比较典型的Harness,就是修复LLM产生的错误工具格式,让Agent能正常调用工具。这些错误比较长尾。有一个典型的例子,就是CommandCodeAI CEO分享的,修复了DeepSeek V4 Pro的一些常见的工具调用格式问题后,在编程任务上性能能够超过原生的Claude Opus 4.7。
DeepSeek V4 Pro在工具调用时候有四种比较典型的错误,简单来说有:
- 可选字段传了 null 而不是省略它
- 把数组写成了长得像数组的字符串
- 调用格式期望数组,模型传了一个裸字符串
- 期望输入数组,模型传了一个空对象作为占位符
这些错误用了一百多行代码,通过规则进行修复。然后极大提升了基于DeepSeek V4 Pro的Agent的效果。
这层做对了的标准是,Agent 能在不用盯着的情况下,跑完一个跨几十步、跨多个工具调用的长程任务,中间不爆上下文、不陷入死循环(不是传统的死循环,而是上文说的复读机情况)、不做不可逆的危险操作,崩了也能从最近的 checkpoint继续工作。做错的表现是,上述的反面。
Harness工程这层,你交出的是单次运行内的过程控制权。Agent在你预设的安全边界里,可以自主决定调哪个工具、走哪条路径、什么时候该压缩历史、什么时候该拆sub-agent 去读外部信息。
但你仍然保留三件事的决定权:任务从哪里开始、安全边界划在哪里、以及碰到边界时是放行还是中断。
换句话说,上下文工程交出去的是看什么,Harness工程交出去的是怎么走。但什么时候出发、走到哪里算完成,这个限制还是在你手里,这部分权力要等 Loop 工程才会进一步交出去。
Step 3:Loop 工程,让系统自己去找 Agent 干活
到这一层,事情变了。Loop工程变成了一个更加宏观、系统的工程。
前两层你都还在用Agent,上下文工程是给 Agent 看什么,Harness 工程是给Agent设立规则让它稳定运行。但不管哪一层,启动按钮都还在你手里。你说一句任务描述,Agent帮你跑完,跑完停下来等你下一句指示。
Loop工程的核心命题是:你不再亲自启动 Agent,而是设计一个系统,由系统来决定什么时候启动 Agent、启动几个、产出谁来验、下一轮从哪接。
按Addy Osmani的拆法,一个能跑起来的loop由六件东西组成,五个基础组件加一个memory。值得一件一件看,因为每一件对应的都不是加一个功能,而是再往外交一层控制权。
第一件,Automations,交出什么时候开工。
手动跑Agent,是你决定什么时候按回车。Automation是让定时器决定,时间一到,它自己读昨天的CI失败、open issues、最近commits,自己决定今天该修哪个。Codex里有Automations标签,Claude Code里是 /loop、cron、生命周期 hook 或者 GitHub Actions,殊途同归。
更隐蔽的一层是/goal,你可以写一个判断条件比如“all tests in test/auth pass and lint is clean”。每一轮跑完,有一个独立的小模型在判断任务是不是已经完成,写代码的那个 Agent 不给自己打分。
真正交出去的不是调度权,而是判断什么时候算完成的角色由人变成了Agent。
第二件,Worktrees,交出并行 Agent 之间的协调。
跑超过一个 Agent编写代码,有个问题在于他们会制造代码冲突,这和两个工程师没互相协调就往同一行提交commit是一回事。git worktree给每个Agent一份独立的checkout,直接硬隔离让一个Agent的修改不会影响另一个的。
但Addy提醒过一句很要紧的话:worktree拿走的是机械冲突,不是你的review能力。能并行跑多少个Agent的天花板还是人,不是工具。
第三件,Skills,交出项目知识的分发。
Skill 这东西和Harness那一层是同一套机制,这层我认为不用多写,本质上无论是Harness中使用Skill还是Loop中使用,没有区别。无非就是Loop更强调多Agent共享同一套Skill。
第四件,Plugins / Connectors(MCP),交出loop 触达真实系统的能力。
Connector让loop能读issue tracker、查数据库、打staging API、往 Slack 扔消息。这是Agent仅返回修复建议和loop自己开 PR、关 ticket、CI 绿了往群里通知一声的区别。
这个层面的事情,其实也和传统的Agent没有什么区别。
第五件,Sub-agents,交出产出该不该结束任务的判断权。
这一层就是换一个有不同指令、不同模型的Agent来进行工作成果的review。和Anthropic那篇博客里最后单独设置一个Verifier Agent进行任务Review没有区别。但是Loop中,因为整个 loop 本身就是开放式、长程的,它评的是“当前进展够不够、要不要继续推进”,标准本身是浮动的,得由你亲自在Loop工程中,对reviewer Agent定义“够不够”的程度。
第六件,Memory / State,交出连续性。
这层方案和传统的记忆存储区别也并不是很大,方案可以很轻,拿一个Markdown文件,记录什么已经做过,什么没有做过的东西就行。
写到这里,你大概会有一个感觉:这六件,每一件看起来都和 Harness 里的某个东西高度重叠。
这个感觉是对的,而且这正是Loop工程最容易被误解的地方。
如果你把这六个组件单拎出来做技术对比,会发现Loop用的东西和Harness几乎完全一样,同样的 sub-agent、同样的skill、同样的MCP、同样的记忆持久化。Loop 没有发明任何一件新组件。可能顶多就是更自动化了?
但真正变了的不是组件本身,是这些组件被放进了一个不一样的时间结构里。
比如回到厨房和餐厅那个比喻。
Harness 里的sub-agent,是厨房里负责出品检查的人。这道菜出锅,他尝一次,味道好就继续出品,味道不好就重做。守的边界是这道菜。
Loop里的sub-agent,是后厨的厨师长。他要回答的问题不是这盘菜行不行,而是下一桌的菜什么时候上,今天的菜品哪个不受欢迎可以从菜单去掉。他守的不再是一道菜的质量,而是从整个营业时段的效果出发,进行任务的重新梳理,他做的判断完全不一样。
Harness里的所有组件,是为这一次任务从开始到结束服务的。任务来了,sub-agent 干活、verifier 验收、checkpoint 兜底,跑完整个harness就退场。整个harness像一条流水线,工件进、成品出,工件没了流水线就停。
Loop里的所有组件,是为这条产线永远不停服务的。Automation在替你决定什么时候开始,sub-agent 在替你决定这一轮的活儿够不够好、要不要再来一轮,state/memory在替你记住昨天做到哪了、今天该接着干什么、上周哪个pattern反复出问题。整个loop更像一个常驻进程,它不是为某个具体任务存在的,它是为某项持续职能存在的。
这层做对了的标准是,系统能在你不参与的情况下持续运转,你只需要每隔一段时间去看一下STATE.md里它都做了什么、有什么没决定的事情升级给你了。
Loop工程这层,你交出的是任务的发起权和验收权。Automation替你决定开工时机,sub-agent里的reviewer替你决定一轮工作够不够格,memory/state替你维护跨轮次的连续性。你保留的只剩两样东西:
- 设计权:loop本身怎么设计,什么pattern、什么运行节奏、谁review 谁、哪些动作需要人工confirm、哪些可以自动merge。
- 升级裁决权:loop自己处理不了、扔到你面前的那些case,由你来做最后判断。
到这一层,你在日常工作中出现的频率应该是肉眼可见地下降的。如果你发现自己还是天天在循环里被cue,那说明这个loop要么设计有问题,要么还没到该上Loop这层的成熟度。
Step 4:那 Loop Engineering 到底是不是凹了个新词
回到一开始那个问题:这三个词是不是同一件事换了三个壳?
我自己梳理完一圈下来的结论是:组件层面高度重复,但决策层级实打实地往上挪了一层。
把三层叠在一起看,最清晰的就是你交出去了什么这条线:
每往下一层,人这个角色在日常工作流里出现的频率就下降一档,而设计这套系统的难度和后果,则上升一档。这才是Loop Engineering 不是凹词的关键,它确实对应了一个新的工程位置,但前提是你愿意承担与之匹配的责任。
绕了一大圈,回到最开头那句话:
你每落地一层,你的决策权就会往上提高一层。
Context Engineering 让你从在prompt里写细节升级到设计给Agent提供信息边界。Harness Engineering让你从设计信息边界升级到设计任务执行的安全护栏。Loop Engineering让你从设计单次任务的护栏升级到设计一项持续职能的运转方式。
这三层是叠加关系,不是替代关系。你不可能跳过Context和Harness这两步直接做 Loop,就像你不可能跳过菜谱和厨房直接开餐厅。但如果你把Context和Harness都做扎实了,Loop这一层就是把你这个人从按回车的人变成设计为什么按回车、什么时候按、谁来按的人。
至于这算不算真正的新东西,我的答案是:组件不算新,位置是新的。而位置变了,工程上要回答的问题就全变了。这就够了,不必非得发明新的组件才叫进步。
作者:酱紫君
链接:https://www.zhihu.com/question/2048003050531558553/answer/2048094419505746085
来源:知乎
著作权归作者所有。商业转载请联系作者获得授权,非商业转载请注明出处。
又开始造词了,有币圈那味了。
从 Vibe Coding 开始,ReAct 范式、spec driven、wish coding、harness 工程、loop 工程,这都第几个了。
拨开 AI 黑话,其实很简单。
Spec 就是给 AI 看的 PRD,Harness 就是给 Agent 用的 Framework,Loop 就更简单了,其实就是 CI。
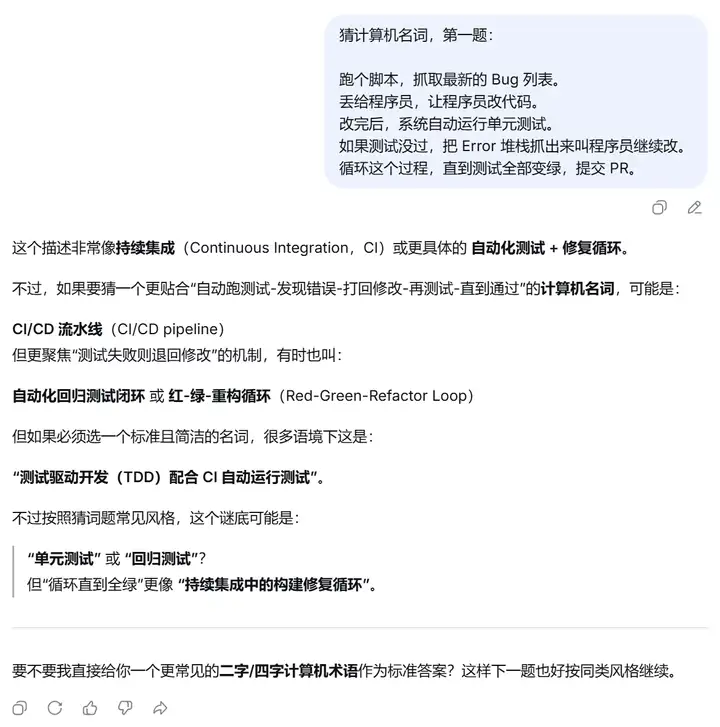
什么叫 Loop 工程呢,根据 AI 造词仙人的定义,大致就是这样一个流程:
- 跑个脚本,抓取最新的 Bug 列表。
- 丢给大模型,让大模型改代码。
- 改完后,系统自动运行单元测试。
- 如果测试没过,把 Error 堆栈抓出来叫大模型继续改。
- 循环这个过程,直到测试全部变绿,提交 PR。
这个过程好像似曾相识啊,你说是不是啊,D 指导?
AI 圈目前所有的工作流创新,本质上都在做一件事:
用大语言模型,把十多年前 DevOps 思想下的 CI/CD 管道全™重新发明一遍。
古法编程是怎么配 Jenkins/GitHub Actions 的?
- 触发机制:开发 Push 了代码,触发 Webhook
- 隔离环境:为了不污染宿主机,起一个干净的 Docker 容器
- 执行任务:在容器里跑
npm install - 验证反馈:跑 ESLint 检查代码规范,跑 Jest 单元测试
- 全绿:打个 Tag,飞书群通知完工
- 红了:飞书里直接骂那个提交代码的人,让他滚回去改
AI 仙人所谓的 Loop 工程新法开发呢,也是一样的:
- 触发机制:Cron Job 定时任务,或者 GitHub 上的新 Issue
- 隔离环境:哦,他们造了个新词,叫 Worktree 沙箱,其实还是个 Docker 容器
- 执行任务:不再跑固定的 CI 脚本,而是烧 Token 叫 Agent 读 Skills 执行
- 验证反馈:依然是 ESLint/Jest,这一步完全没有 AI,看来还是有点脑子的,我还以为会叫 AI 一行一行检查呢
- 全绿:AI 打个 Tag,飞书群通知完工
- 红了:编辑器里直接骂大模型,让它滚回去改
再这样下去,过段时间,AI 造词仙人就要重新发明 CD 了。
持续交付、灰度发布、混沌工程,这些老词不知道能被他们编出来些什么新的花样。
学习,学个屁,本来就没什么新东西。
商业需要故事,VC 需要概念,所以就只能没活硬抄(不是炒)。
应用层的 AI 开发者实在是想不出什么新花样了,只能转头去翻翻经典的计算机体系结构、翻翻 DevOps 教科书、翻翻控制论。
把里面的方法论全抄过来,裹上一层 AI 的糖衣,当成伟哥卖给大众。
如果你跟着他们的节奏陪跑,你就会累死,觉得自己是个铁废物,前面的还没学会后面又来了。
反之,静静坐下,让子弹飞一会儿,笑看 AI 仙人的小丑行为,等他们把这些脑残的黑话都造完,把泡沫吹破就行。
只要你学得够慢,你就可以什么都不用学。